
Сетевые инженеры часто сталкиваются с ситуацией, когда маршрут, прописанный вручную, перестает работать из-за обрыва кабеля или выхода из строя порта. Пока администратор не изменит конфигурацию, трафик продолжит уходить в недоступный канал и теряться. Чтобы автоматизировать процесс адаптации сети к изменениям, были созданы протоколы динамической маршрутизации. Один из ключевых протоколов этого класса, широко применяемый сегодня в корпоративных и облачных средах, — OSPF.
В этой статье мы разберем его принцип работы. Посмотрим, почему статическая маршрутизация накладывает серьезные ограничения на развитие сети и как OSPF эти ограничения снимает. Затем пройдем полный цикл работы протокола — от первого обмена служебными сообщениями до построения готовой таблицы маршрутизации. Отдельно остановимся на типах пакетов и выясним, зачем в сегменте с большим количеством устройств назначаются выделенный и резервный маршрутизаторы.
В этом тексте:
Что такое OSPF
OSPF (Open Shortest Path First) — это протокол динамической маршрутизации, который автоматически отслеживает изменения в топологии сети и прокладывает кратчайший путь для передачи данных между узлами. Он работает внутри одной автономной системы и принимает решения на основе актуальной информации о состоянии всех доступных каналов связи.
Слово Open в названии указывает на открытый стандарт. Спецификация протокола опубликована и доступна любому производителю оборудования. Благодаря этому роутеры разных вендоров могут работать в одной сети без конфликтов и необходимости в проприетарных надстройках. Для сравнения: у компании Cisco существует протокол EIGRP, который долгое время был закрытым и поддерживался только на оборудовании этого производителя. OSPF же изначально проектировался как универсальный инструмент.
Аббревиатура SPF отсылает к математической основе протокола — алгоритму Дейкстры (Shortest Path First). Этот алгоритм позволяет вычислить оптимальный маршрут до каждой известной сети, имея на руках полную карту топологии. В отличие от более простых протоколов, которые опираются на данные соседей и могут пропустить петлю, OSPF строит дерево кратчайших путей самостоятельно, помещая себя в его корень.
К какому классу протоколов относится
OSPF принадлежит к двум важным категориям, и обе стоит зафиксировать явно.
Первая категория — IGP (Interior Gateway Protocol), или протокол внутренней маршрутизации. Это означает, что зона его ответственности ограничена одной автономной системой — сетью под единым административным управлением. Для маршрутизации между разными автономными системами применяются протоколы другого класса, например BGP.
Вторая категория — Link-State, то есть протокол состояния каналов. Этот момент принципиально отличает OSPF от дистанционно-векторных протоколов вроде RIP. Дистанционно-векторная логика напоминает распространение слухов: роутер знает только то, что сообщил ему непосредственный сосед, и передает эту информацию дальше, увеличивая метрику. Ошибка на одном узле может распространиться по всей сети. Link-State подход устроен иначе. Каждый роутер собирает данные о состоянии своих каналов и рассылает их всем остальным участникам. В результате на каждом узле формируется идентичная база данных, описывающая всю топологию. Решение о маршруте принимается на основе полной картины, а не фрагментарных сведений от соседа.
Зачем нужен и где применяется
Потребность в OSPF возникает тогда, когда сеть перерастает возможности статической маршрутизации. Перечислим ключевые задачи, которые решает протокол.
Автоматическая реакция на отказы. При обрыве кабеля, падении порта или выходе из строя промежуточного роутера OSPF фиксирует изменение и за доли секунды перестраивает маршрут в обход поврежденного участка. Администратору не нужно вмешиваться в процесс — передача данных восстанавливается автоматически.
Балансировка нагрузки. Если между двумя точками существует несколько равноценных путей с одинаковой метрикой, OSPF помещает их в таблицу маршрутизации одновременно. Трафик распределяется между ними, что повышает пропускную способность и утилизацию каналов. Такой механизм называется ECMP (Equal-Cost Multi-Path).
Масштабирование. При росте сети объем служебной информации, которой обмениваются роутеры, неизбежно увеличивается. OSPF решает эту проблему делением на зоны (Area). Роутеры внутри одной зоны хранят детальную топологию только своего сегмента, а о других зонах получают обобщенные данные. Это снижает нагрузку на процессор и память каждого устройства.
Независимость от вендора. Открытый стандарт позволяет комбинировать оборудование разных производителей в рамках одной сети. Инженер может использовать роутеры Juniper на ядре и MikroTik на уровне доступа, и OSPF будет корректно работать на всех устройствах.
С точки зрения сфер применения протокол давно вышел за пределы классических офисных сетей. Его используют в следующих сценариях:
- корпоративные распределенные сети с десятками филиалов;
- центры обработки данных, где требуется быстрое переключение между маршрутами;
- облачные платформы, в которых виртуальные роутеры обеспечивают связность между клиентскими сегментами;
- VPN-сети на базе туннелей GRE или IPsec, где OSPF автоматически отслеживает доступность удаленных площадок.
Во всех этих случаях OSPF работает как механизм, который превращает набор независимых устройств в единую, саморегулирующуюся систему передачи данных.
Основы протокола OSPF
Чтобы оценить возможности OSPF, стоит немного погрузиться в статическую маршрутизацию и ее ограничения.
Ограничения статической маршрутизации
Статическая маршрутизация — это ручной метод управления трафиком. Администратор заходит на роутер и явно указывает: для достижения определенной подсети нужно отправить пакет на конкретный IP-адрес следующего узла. Запись выглядит, например, так:
ip route 192.168.10.0 255.255.255.0 10.0.0.1Роутер выполняет эту инструкцию безоговорочно, не проверяя, доступен ли адрес 10.0.0.1 в данный момент.
Главные ограничения статического подхода проявляются быстро. При отказе канала маршрут остается в таблице, и трафик уходит в недоступный интерфейс до ручного вмешательства инженера. При росте сети количество записей, которые нужно поддерживать на каждом устройстве, растет лавинообразно. Ошибка в одном адресе или маске приводит к труднодиагностируемым сбоям. Статика хорошо работает в маленьких и неизменных сегментах, но перестает справляться, как только на первый план выходят требования к масштабируемости и отказоустойчивости.
Что привносит OSPF
OSPF снимает перечисленные ограничения за счет принципиально иного подхода. Вместо того чтобы описывать каждый маршрут вручную, администратор задает правила участия роутера в протоколе. Все остальное устройства делают сами.
Автоматическое обнаружение соседей и топологии. Роутер с включенным OSPF самостоятельно находит другие устройства, работающие по тому же протоколу, и собирает данные о доступных каналах. Администратору не нужно прописывать десятки IP-адресов следующих узлов. Достаточно указать, какие интерфейсы участвуют в процессе и к какой зоне они относятся. Все маршруты строятся автоматически на основе собранной информации.
Мгновенная реакция на изменения. Когда канал падает или восстанавливается, OSPF фиксирует событие и немедленно оповещает о нем остальные роутеры. Те, в свою очередь, пересчитывают маршруты уже без учета отказавшего сегмента. Время от аварии до восстановления связности измеряется долями секунды. Для клиентов облачного провайдера это означает, что обрыв одного физического линка не приводит к заметному перерыву в работе сервисов.
Единая база данных топологии. Каждый роутер под управлением OSPF хранит идентичную копию карты сети в пределах своей зоны. Решения о выборе маршрута принимаются на основе одного и того же набора данных. Это устраняет ситуацию, когда два устройства по-разному видят путь до одной и той же подсети, и практически исключает образование петель.
Балансировка нагрузки. Если между двумя точками существует несколько путей с одинаковой метрикой, OSPF помещает их в таблицу маршрутизации одновременно. Трафик распределяется между ними без дополнительных настроек. Это повышает пропускную способность сети и позволяет эффективнее использовать имеющиеся каналы.
Деление на зоны. При росте сети объем служебной информации, которой обмениваются роутеры, увеличивается. OSPF решает эту проблему с помощью зон (Area). Устройства внутри одной зоны хранят детальную топологию только своего сегмента, а о других зонах получают обобщенные данные. Это снижает нагрузку на процессор и память каждого роутера и делает протокол пригодным для крупных развертываний.
Открытый стандарт. OSPF работает на оборудовании любых производителей. Инженер может использовать роутеры разных вендоров на разных уровнях сети, и протокол будет корректно выполнять свои функции без дополнительных надстроек.
На практике переход со статики на OSPF меняет саму модель управления сетью. Администратор перестает контролировать каждый отдельный маршрут и переходит к описанию логики взаимодействия устройств. Роутеры самостоятельно поддерживают актуальную картину сети, адаптируются к отказам и восстанавливают связность без участия человека.
Облачная инфраструктура для корпоративной сети
Специалисты ИТ-ГРАД помогут спроектировать отказоустойчивую сетевую топологию, настроить динамическую маршрутизацию и развернуть виртуальную инфраструктуру под высоконагруженные проекты
Принцип работы OSPF
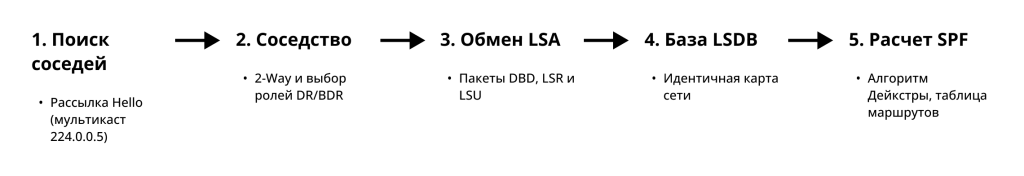
После включения OSPF на интерфейсах роутер проходит через несколько обязательных этапов. Отправной точкой служит пустая таблица маршрутизации и отсутствие какой-либо информации о соседях. Конечным результатом становится готовая карта сети и набор оптимальных маршрутов до каждой известной подсети. Разберем этот процесс по шагам.
Этап 1: Поиск соседей
Первое, что делает роутер после запуска OSPF, — рассылает Hello-пакеты через все интерфейсы, на которых активирован протокол. Эти пакеты отправляются на мультикастовый адрес 224.0.0.5. Их получают все устройства в том же широковещательном сегменте, которые тоже слушают этот адрес.
Hello-пакет содержит набор параметров, критичных для установления контакта:
- Router ID — уникальный идентификатор роутера в сети OSPF;
- Area ID — номер зоны, к которой принадлежит интерфейс;
- маска подсети интерфейса;
- таймеры Hello и Dead, определяющие периодичность отправки пакетов и время, после которого сосед считается потерянным;
- приоритет, влияющий на выбор выделенного роутера;
- список уже известных соседей.
Для того чтобы два роутера увидели друг друга, значения Area ID, маски подсети и таймеров должны совпадать. Если параметры различаются, Hello-пакеты принимаются, но соседство не устанавливается. Это механизм защиты от случайного объединения устройств из разных сегментов.
Этап 2: Установка соседства
Получение Hello-пакета еще не означает полноценного партнерства. Роутеры проходят через несколько промежуточных состояний, прежде чем начать обмен маршрутной информацией.
Начальное состояние называется Down. Роутер еще ничего не знает о соседе. Получив первый Hello-пакет, он переходит в состояние Init — сосед обнаружен, но ответного подтверждения нет. Когда в полученном Hello-пакете роутер видит собственный Router ID в списке известных соседей, он понимает, что связь двусторонняя, и переходит в состояние 2-Way. На этом этапе соседство зафиксировано.
Однако не все пары роутеров в состоянии 2-Way идут дальше. В сетях с множественным доступом, таких как Ethernet, полносвязный обмен данными между всеми участниками создал бы слишком много служебного трафика. Поэтому часть роутеров останавливается на стадии 2-Way, а полноценный обмен маршрутной информацией происходит только с выделенным и резервным роутерами. Между остальными устройствами и DR устанавливается состояние Full, означающее полную синхронизацию баз данных.
Перед обменом данными два роутера договариваются, кто будет управлять процессом. Роль мастера получает устройство с большим Router ID. Ведомый принимает правила синхронизации, заданные мастером. Этот механизм упрощает последовательную передачу больших объемов информации о топологии.
Этап 3: Обмен LSA
После установления отношений мастер и слейв начинают синхронизацию. Единицей информации в OSPF выступает LSA (Link-State Advertisement) — объявление о состоянии канала. Каждый LSA описывает часть топологии: например, информацию о подключенной сети, о доступном соседе или о внешнем маршруте, пришедшем из другой автономной системы.
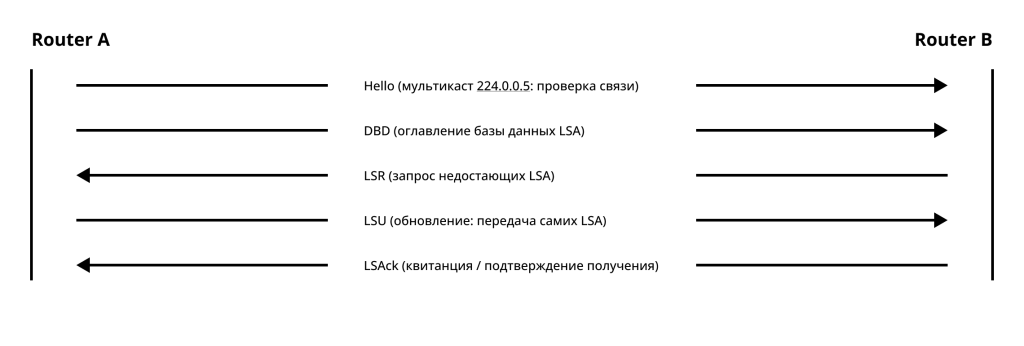
Процесс обмена состоит из нескольких шагов. Сначала роутеры обмениваются пакетами Database Description (DBD), которые содержат заголовки всех известных LSA. Это напоминает обмен оглавлениями книг. Получив оглавление соседа, роутер сравнивает его со своим и понимает, каких данных ему не хватает. Недостающие LSA он запрашивает отдельно с помощью пакетов Link-State Request. В ответ приходят пакеты Link-State Update, внутри которых находятся сами LSA. Получив обновление, роутер подтверждает доставку пакетом Link-State Acknowledgment.
Когда новый LSA появляется в сети — например, из-за подключения новой подсети или падения канала — он рассылается лавинным методом. Роутер, получивший новое объявление, передает его на все активные интерфейсы, кроме того, с которого оно пришло. Это гарантирует быстрое распространение информации по всей зоне.
Этап 4: Синхронизация LSDB
Результатом обмена становится LSDB (Link-State Database) — база данных состояния каналов. После успешной синхронизации содержимое LSDB идентично на всех роутерах в пределах одной зоны.
Важно понимать разницу между LSDB и таблицей маршрутизации. LSDB — это сырая карта сети, набор всех полученных LSA. Она описывает топологию целиком: какие роутеры есть в сети, как они соединены между собой, какие подсети к ним подключены и какова стоимость каждого канала. Но сама по себе LSDB не говорит, куда отправлять пакет до конкретной сети. Это лишь исходные данные для вычислений.
Этап 5: Запуск алгоритма SPF и построение таблицы маршрутизации
Получив полную LSDB, роутер запускает алгоритм Дейкстры (SPF). Он помещает себя в корень дерева и вычисляет кратчайший путь до каждой известной сети. Ключевым параметром при расчете выступает метрика, или стоимость канала.
Стоимость в OSPF рассчитывается по формуле:
Cost = Reference Bandwidth / Interface Bandwidth
Значение Reference Bandwidth по умолчанию составляет 100 Мбит/с. Для интерфейса FastEthernet (100 Мбит/с) стоимость будет равна 1, для гигабитного — тоже 1 из-за ограничения целочисленной арифметики. На практике значение Reference Bandwidth часто меняют на большее, чтобы корректно различать стоимость высокоскоростных интерфейсов.
Алгоритм SPF последовательно находит узлы с наименьшей совокупной стоимостью и строит дерево, свободное от петель. После завершения вычислений лучшие маршруты попадают в таблицу маршрутизации. Если до одной сети существует несколько путей с одинаковой стоимостью, OSPF добавляет их все, автоматически включая балансировку нагрузки.
При любом изменении топологии — отказе канала, появлении нового соседа, изменении стоимости — цикл повторяется. Роутер генерирует новый LSA, рассылает его, обновляет LSDB и перезапускает алгоритм SPF. Так поддерживается актуальность маршрутной информации в реальном времени.
Типы пакетов OSPF
Остановимся отдельно на служебных сообщениях, с помощью которых этот процесс реализован. OSPF использует пять типов пакетов, каждый со своей задачей. Все они инкапсулируются непосредственно в IP-пакеты с номером протокола 89.
Hello
Hello-пакеты выполняют две функции: обнаружение соседей и поддержание уже установленных отношений.
При включении OSPF на интерфейсе роутер начинает периодически отправлять Hello-пакеты на мультикастовый адрес 224.0.0.5. Интервал отправки по умолчанию составляет 10 секунд для широковещательных сетей и 30 секунд для нешироковещательных. Внутри пакета передаются Router ID отправителя, Area ID, маска подсети, таймеры и список соседей, которых отправитель уже знает.
Если роутер перестает получать Hello-пакеты от ранее известного соседа, он ждет в течение интервала Dead (по умолчанию в четыре раза больше интервала Hello). После этого сосед объявляется недоступным, генерируется новое LSA и запускается пересчет маршрутов.
Database Description
Database Description, или DBD, используется на этапе начальной синхронизации баз данных. Его задача — передать соседу список всех LSA, которые уже есть в LSDB отправителя.
DBD-пакет содержит заголовки LSA, а не сами объявления целиком. Это позволяет быстро сравнить содержимое баз двух роутеров и понять, каких данных не хватает каждой стороне. Обмен происходит в режиме мастер-слейв: ведущий роутер управляет последовательностью передачи, ведомый подтверждает получение и отправляет свои заголовки в ответ.
Link-State Request
Получив DBD от соседа, роутер анализирует заголовки и определяет, какие LSA у него отсутствуют или устарели. Для каждого такого объявления он формирует пакет Link-State Request.
LSR содержит идентификаторы запрашиваемых LSA: тип объявления, Router ID источника и номер сети. Получив такой запрос, сосед понимает, какие именно данные нужно выслать. Один пакет LSR может запрашивать сразу несколько LSA.
Link-State Update
Link-State Update — это транспортный контейнер, внутри которого передаются сами LSA. LSU отправляется в трех случаях:
- в ответ на полученный LSR, чтобы предоставить запрошенную информацию;
- при изменении топологии, чтобы оповестить соседей о новом состоянии канала;
- периодически, для обновления устаревающих записей (каждые 30 минут по умолчанию).
Каждый LSU может содержать несколько LSA. При получении LSU роутер проверяет каждое объявление, добавляет его в LSDB и запускает лавинную рассылку дальше по всем активным интерфейсам, кроме того, с которого пакет пришел.
Link-State Acknowledgment
LSAck выполняет функцию квитанции. Каждый полученный LSU должен быть подтвержден, чтобы отправитель знал: информация доставлена и обработана.
Отсутствие подтверждения заставляет отправителя повторно выслать LSU. Это обеспечивает надежность распространения данных о топологии. LSAck может подтверждать как один LSU, так и группу пакетов — в одном сообщении допустимо перечислить несколько подтвержденных LSA.
Пять описанных типов пакетов образуют замкнутый цикл. Hello находит соседа и следит за его доступностью. DBD сверяет базы данных. LSR запрашивает недостающее. LSU доставляет данные. LSAck подтверждает получение. В совокупности эти сообщения обеспечивают синхронизацию LSDB на всех роутерах зоны и оперативное распространение информации о любых изменениях топологии.
Выбор DR и BDR
В широковещательных сетях с множественным доступом, таких как Ethernet, количество роутеров в одном сегменте может быть значительным. Если каждое устройство начнет обмениваться LSA со всеми остальными напрямую, объем служебного трафика и нагрузка на процессоры вырастут неприемлемо. Для решения этой проблемы OSPF вводит роли выделенного и резервного маршрутизаторов.
Проблема полносвязной топологии
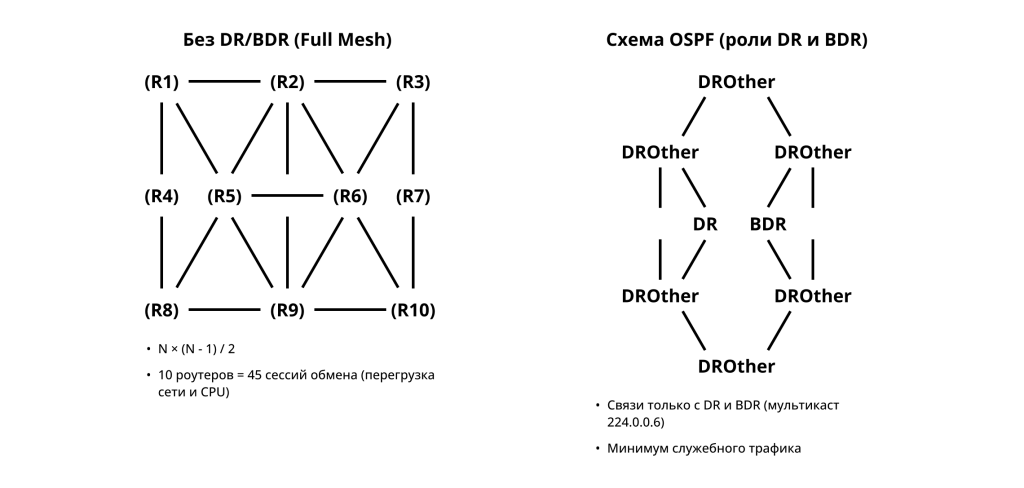
Представим сегмент сети, в котором работают десять роутеров. При полносвязной модели каждый из них должен установить соседство и синхронизировать базу данных с девятью другими. Количество взаимодействий растет квадратично: для N устройств требуется N × (N − 1) / 2 сессий обмена. При десяти роутерах это 45 пар, при двадцати — уже 190.
Каждое изменение топологии в такой среде порождает лавину LSU, которые отправляются по всем этим сессиям. Роутеры тратят ресурсы на многократную обработку одних и тех же данных. В крупных широковещательных доменах это приводит к деградации производительности и нестабильности.
Роли в сети с множественным доступом
Для оптимизации процесса OSPF назначает в каждом широковещательном сегменте двух специальных участников.
Designated Router (DR) — выделенный маршрутизатор, который становится центральной точкой обмена маршрутной информацией. Все остальные роутеры в сегменте устанавливают полное соседство только с DR и синхронизируют свои LSDB именно с ним. Когда у какого-либо роутера появляется новое LSA, он отправляет его на мультикастовый адрес 224.0.0.6, который слушают только DR и BDR. Получив обновление, DR рассылает его всем остальным участникам сегмента на адрес 224.0.0.5.
Backup Designated Router (BDR) — резервный маршрутизатор. Он также устанавливает полное соседство со всеми роутерами сегмента, получает все LSA и синхронизирует свою базу данных, но не выполняет функции DR, пока тот активен. BDR находится в режиме ожидания и готов взять на себя роль DR немедленно после обнаружения его отказа.
Роутеры, которые не являются ни DR, ни BDR, называются DROther. Они устанавливают состояние Full только с DR и BDR, а между собой остаются в состоянии 2-Way. Этого достаточно: маршрутная информация передается через DR, и прямая синхронизация между DROther не требуется.
Механизм выбора
Выбор DR и BDR происходит автоматически на основе двух параметров: приоритета интерфейса и Router ID.
Приоритет — это числовое значение, которое администратор может задать для каждого интерфейса, участвующего в OSPF. Диапазон значений — от 0 до 255. Приоритет 0 означает, что роутер не может быть выбран ни DR, ни BDR. Если администратор хочет гарантированно назначить определенное устройство на роль DR, он выставляет ему наивысший приоритет в сегменте.
Router ID выступает в роли дополнительного критерия. Если приоритеты двух роутеров равны, побеждает устройство с большим Router ID. Поскольку Router ID всегда уникален, этот механизм гарантирует однозначный результат даже при полностью одинаковых настройках приоритетов.
Процесс выбора запускается при появлении первого роутера в сегменте и завершается до начала обмена маршрутной информацией. Приоритет и Router ID передаются внутри Hello-пакетов, поэтому каждый участник видит параметры соседей еще на этапе обнаружения.
Стабильность ролей
Одно из ключевых свойств механизма DR/BDR — отсутствие перевыборов без необходимости. Если в работающий сегмент добавляется новый роутер с более высоким приоритетом, он не смещает текущего DR. Выборы запускаются заново только при отказе DR. В этом случае BDR немедленно занимает его место, а среди оставшихся роутеров выбирается новый BDR.
Такое поведение обеспечивает стабильность сети. Постоянные перевыборы при каждом изменении состава устройств приводили бы к разрывам синхронизации и пересчету маршрутов. Фиксация ролей до момента реального отказа позволяет избежать этой нестабильности.
На что не влияют DR и BDR
Роли DR и BDR относятся исключительно к служебному обмену — передаче LSA и синхронизации LSDB. Они не затрагивают пересылку пользовательского трафика. Пакеты данных продолжают передаваться по тем маршрутам, которые были вычислены алгоритмом SPF и помещены в таблицу маршрутизации. DR не становится транзитным узлом для всего трафика в сегменте и не добавляет дополнительных задержек.
Таким образом, механизм DR и BDR оптимизирует именно контрольную плоскость протокола, оставляя плоскость данных нетронутой. Это элегантное решение позволяет масштабировать OSPF в крупных широковещательных доменах без потери производительности и надежности.
Заключение
По мере роста числа узлов и повышения требований к надежности в любой сети возникает потребность в автоматическом поддержании связности без постоянного участия администратора. Именно эту задачу решает динамическая маршрутизация. OSPF остается одним из наиболее востребованных протоколов для этого класса задач благодаря открытому стандарту, быстрой сходимости и продуманной архитектуре с делением на зоны.
Если вы планируете развернуть виртуальную инфраструктуру с надежной связностью под высоконагруженные проекты, вы можете обратиться к специалистам облачного провайдера ИТ-ГРАД. Мы поможем спроектировать сетевую топологию с учетом требований к отказоустойчивости и производительности, настроим динамическую маршрутизацию и обеспечим бесперебойную работу ваших сервисов в облаке.
Похожие статьи
05.06.2026
10 минут чтения
Принципы работы CDN
Разница в загрузке сайта зависит от расстояния между пользователем и сервером. CDN решает эту проблему на уровне архитектуры и параллельно защищает проект от пиковых нагрузок и DDoS-атак
IT-инфраструктура
26.05.2026
10 минут чтения
X-as-a-Service: как выбрать нужную модель
Облака давно перестали быть просто арендой серверов. Теперь это десятки узкоспециализированных сервисов, за каждым из которых скрывается своя аббревиатура и своя зона ответственности. Рассказываем, как не запутаться в этих терминах и выбрать нужную м…
IT-инфраструктура
17.04.2026
12 минут чтения
Облака для банков. Как внедрить цифровые решения и сохранить надежность
Облачные технологии в банковской сфере ускоряют множество процессов. Однако важно всегда держать баланс между внедрением новых инструментов и сохранением безопасности. В статье разбираем, как облака меняют рынок финтеха
IT-инфраструктура
Спасибо за ваше обращение
Спасибо за ваше обращение!Наш менеджер скоро обработает ваш запрос.
А пока вы можете почитать статьи в нашем экспертном блоге.